核对日期:2026-10-24。覆盖6家国内模型厂商、5家海外模型厂商及1家海外托管平台。价格统一按每100万 Token列出,¥为人民币,$为美元。点击平台名称查看官方定价。
先看懂费用
输入包括提示词、对话历史、工具结果和送入模型的文件内容;输出包括回答及按平台规则收费的思考 Token。Token 不是字数,不同模型的分词方式不同。
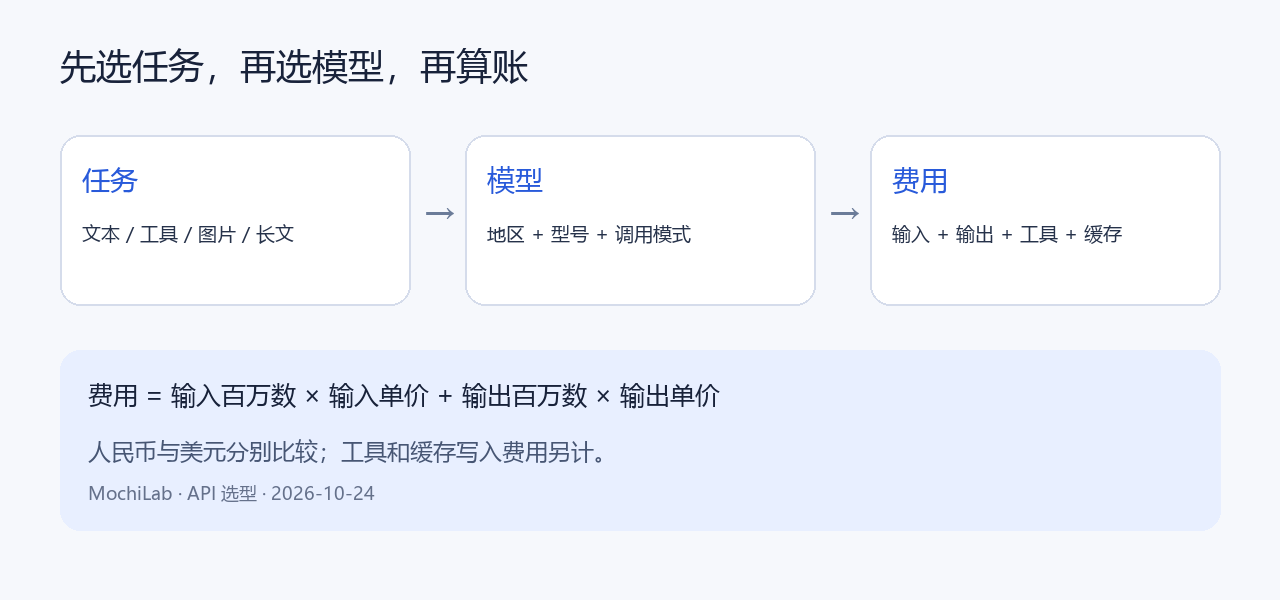
基础费用 = 输入 Token ÷ 100万 × 输入单价 + 输出 Token ÷ 100万 × 输出单价。 以下采用常规按量报价,缓存命中单列;Batch、优先服务、搜索、图片生成等另算。聊天会员和 Coding Plan 的订阅费与这里的 API 账单分开。
国内模型厂商
分组按模型厂商归属;其中 GLM 的数字为国际平台美元价。Kimi 原厂动态价格表未能读取到具体数字,保留官网入口,不代填旧型号价格。
deepseek-flash:输入 ¥2 / 输出 ¥8,每百万 Token。
中文问答、推理、图像理解与工具调用,可先用于日常助手和 Skills 测试。 原厂高峰价;空闲时段 ¥1 / ¥4;缓存命中 ¥0.04 / ¥0.02。
qwen3.8-flash:输入 ¥0.8 / 输出 ¥2.7,每百万 Token。
千问系列覆盖通用文本与多模态;按任务选择 Flash、Max 或对应多模态型号。 北京地域,输入≤1M;新加坡报价不同。
doubao-seed-2.1-lite:输入 ¥0.8 / 输出 ¥2.7,每百万 Token。
豆包模型及多种托管模型统一接入;文本、音频和视频应分别选型、分别算费。 常规在线,非音频输入≤1024K;缓存命中 ¥0.16,存储另计。
MiniMax-M3.1-Flash:输入 ¥1 / 输出 ¥4,每百万 Token。
可比较其文本模型与独立的语音、视频服务;这里报价仅为文本模型。 国内开放平台;缓存读取 ¥0.10。
GLM-5.3-Flash:输入 $0.15 / 输出 $0.50,每百万 Token。
GLM 系列可用于文本和智能体流程;接入前区分国内 BigModel 与国际 Z.ai 的账号、模型和价格。 Z.ai 国际平台美元价,非国内人民币价;缓存命中 $0.03。
kimi-k3:原厂价格见官方定价页。
K3 面向长上下文、文档、视觉与多步工具任务;原厂 API 按量付费,与 Kimi 会员、Kimi Code 分开。 原厂价见动态定价表;下文另列已核对的托管报价。
DeepSeek 的高峰为北京时间周一至周五(中国法定节假日除外)09:00–12:00、14:00–18:00,其余为空闲时段。阿里云、火山方舟采用指定地域与常规在线报价。
Kimi 的另一种接入路径:Together 托管 Kimi K3 输入 $3、输出 $15,缓存命中输入 $0.30 / 百万 Token。这是向 Together 付费的报价,不能当作 Kimi 原厂人民币价。托管型号与定价 ↗
海外平台
gpt-6.1-sol:输入 $2 / 输出 $10,每百万 Token。
通用推理、代码、结构化输出与工具工作流;同平台 Luna 更适合先测试简单高频任务。 Standard、短上下文档;缓存命中 $0.10。
Claude Sonnet 5.5:输入 $2 / 输出 $10,每百万 Token。
可用于代码、写作和长任务;Sonnet、Opus、Haiku 分工不同,按任务复杂度选择。 标准价;缓存命中 $0.10,5分钟写入 $2.50。
gemini-4-argon:输入 $2 / 输出 $10,每百万 Token。
Argon 面向复杂工程、数学科学和多步智能体;图片、音频、视频还需看所选 Gemini 型号。 Standard 优惠至2026-11-30;2026-12-01起 $4 / $20。
Mistral Small 4:输入 $0.15 / 输出 $0.60,每百万 Token。
通用模型之外,还有 Codestral、OCR 和语音接口,适合把文档与代码工具分开选型。 Standard;缓存命中 $0.015。
grok-4.7:输入 $2 / 输出 $6,每百万 Token。
文本、推理与工具流程;需要网络或 X 数据时显式启用对应搜索工具,并计入工具费。 全球端点,输入<200K;≥200K为 $4 / $12。
gpt-oss-120B:输入 $0.15 / 输出 $0.60,每百万 Token。
托管多家机构的开放模型,适合比较不同模型。模型来自谁、由谁托管、向谁付费要分别确认。 Serverless 托管平台报价;不是 OpenAI 原厂 GPT API 报价。
Gemini Argon 的优惠截止日期要计入长期预算。Grok 使用美国区域端点时,Token 价格是全球端点的1.1倍。OpenAI 采用 Standard 短上下文档,长上下文和其他服务档位应按官网对应价格计算。
1亿 Token 大约多少钱
以整月累计 8000万输入 + 2000万输出为例,假设分散为符合表中价格档位的请求,全部未命中缓存、不含额外工具费:
- DeepSeek Flash,全在高峰 / 全在空闲:¥320 / ¥160
- Qwen3.8 Flash,北京:¥118
- MiniMax M3.1 Flash,国内平台:¥160
- OpenAI gpt-6.1-sol,Standard 短上下文档:$360
- OpenAI gpt-6-luna,相同服务与上下文档:$18
这是假设用量的计算,不是月套餐。真实账单还取决于缓存、思考长度、重试和每次请求所属档位。
给 OpenClaw 和 Skills 怎么选
以下是选型建议:
- 中文日常助手、免费 Skills 测试:先从 DeepSeek Flash、Qwen Flash、Doubao Lite、MiniMax Flash 中选一个跑真实任务。
- 复杂代码和多步工具任务:对比 GPT Sol、Claude Sonnet、Kimi K3、GLM 对同一任务的完成率、耗时与总费用。
- 长文、图表、音视频:先确认该型号的输入模态、上下文和计费单位;平台提供多模态服务不等于每个型号都支持。
- 比较多个开放模型:可以使用 Together,分别记录模型名称、托管方和实际路由价格。
先做三项测试:①按要求生成文件并读回;②连续调用工具完成多步任务;③从文件中提取数字并核对来源。记录是否完成、首字等待、总耗时和费用,再确定主力与备用模型。
Skill 的文件处理、备份、转换等功能由工具执行。模型需要正确选择工具、传参数并检查结果;便宜模型能聊天,不代表能稳定完成整套流程。模型 API Key、搜索服务 Key、记忆检索所需的 Embedding Key 也应分别配置。
接入前核对这5项
- 账号和服务器所在地区是否受支持,延迟是否可接受。
- 模型 ID、接口协议及 OpenClaw 版本是否匹配;兼容接口仍需实测工具调用。
- 设置消费提醒与限额,从少量充值开始。
- Key 放服务器私有配置;截图和公开教程隐藏凭据、账号及个人信息。
- 检查上下文、并发、缓存写入/存储、搜索调用和媒体费用;按量账单与订阅分开比较。
本文为2026-10-24的价格快照,选型建议基于上述用途;开通时核对对应地域、型号和服务档位的官方报价。